创建第一张数据表
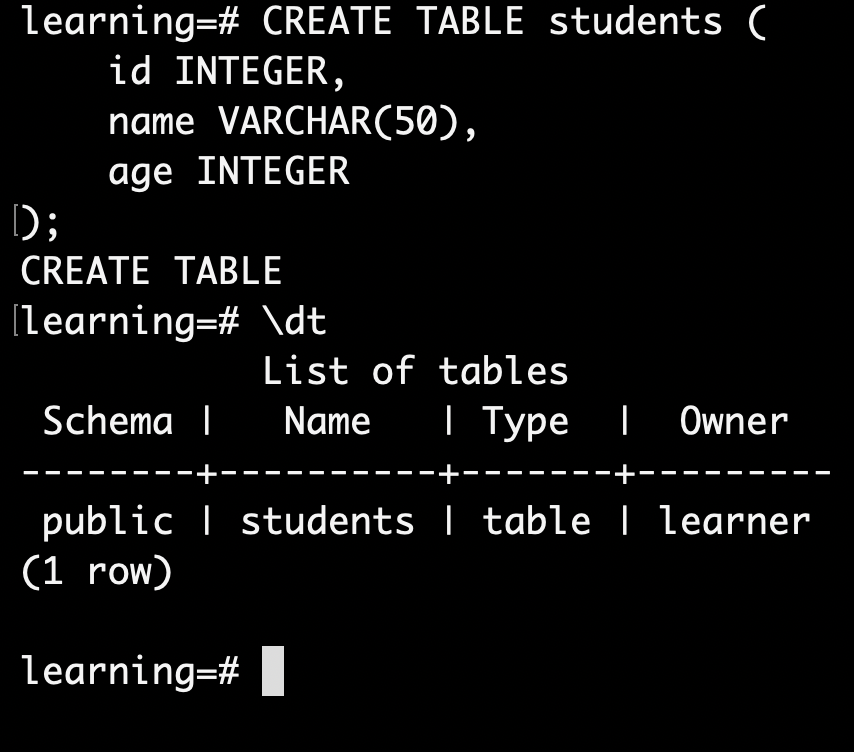
在 learning=# 后执行:
CREATE TABLE students (
    id INTEGER,
    name VARCHAR(50),
    age INTEGER
);
CREATE TABLE:创建数据表。students:表名。id INTEGER:学号,整数类型。name VARCHAR(50):姓名,最多 50 个字符。age INTEGER:年龄,整数类型。
为什么需要 Schema?
假设你有一个博客数据库,里面有很多不同类型的数据:
users:用户信息articles:文章comments:评论orders:订单
如果所有表都放在同一个 Schema 中,表多了就不容易管理。
可以通过 Schema 分类:
这样即使两个 Schema 中存在同名表,也不会冲突。
例如:
SELECT * FROM blog.users;这里的 blog.users 表示 blog Schema 下的 users 表。
那么 public 是什么?
public 是 PostgreSQL 数据库默认创建的 Schema。
我们刚才创建表时:
CREATE TABLE students (...);没有指定 Schema,所以 PostgreSQL 默认将它创建在 public 中。
它的完整名称就是:
public.students动手验证
执行:
SELECT schemaname, tablename
FROM pg_tables
WHERE tablename = 'students';
这条 SQL 会查询系统目录,查看 students 表属于哪个 Schema。
你应该看到:
 schemaname | tablename
------------+----------
 public     | students
记住这个关系:Database → Schema → Table → Row。
接下来学习 PostgreSQL 中非常重要的概念:数据类型(Data Types)。
创建表时,每一列都必须定义数据类型。它决定了这一列能够存储什么数据。
认识常见数据类型
PostgreSQL 常用的数据类型:
几个需要注意的地方:
VARCHAR(50):限制字符串长度为 50。TEXT:适合存储文章、描述等较长文本。NUMERIC(10,2):总共最多 10 位数字,其中小数部分 2 位,适合金额。BOOLEAN:只能表示真或假,也可以是NULL。
接下来学习一个非常重要的概念:主键(PRIMARY KEY)。
第四课:什么是主键?
假设学生表里有这些数据:
id 用来唯一识别每个学生。
主键有两个核心要求:
唯一性:不能有两条记录使用相同的主键。
非空性:主键不能是
NULL。
例如,两个学生可以都叫张三,但不能拥有相同的 id。
动手操作:给 id 添加主键
在 PostgreSQL 中执行:
ALTER TABLE students ADD PRIMARY KEY (id);解释:
ALTER TABLE:修改已有的数据表。students:要修改的表。ADD PRIMARY KEY (id):将id设置为主键。
执行成功后应该显示:
ALTER TABLE然后执行:
\d students你应该能看到 id 字段上出现 PRIMARY KEY 对应的索引信息。
注意: 当前表还没有数据,所以可以安全地添加主键。以后如果表中已有重复的 id 或 NULL,添加主键就可能失败。
第五课:自动增长 ID(IDENTITY)
目前我们插入学生数据时,需要自己填写 id:
INSERT INTO students (id, name, age)
VALUES (1, '张三', 20);
但实际开发中,我们通常希望数据库自动生成 ID,而不是每次手动编号。
PostgreSQL 推荐使用 GENERATED ... AS IDENTITY。
修改 id 字段
执行:
ALTER TABLE students
ALTER COLUMN id ADD GENERATED ALWAYS AS IDENTITY;
它的意思是:让 PostgreSQL 自动生成 id。
不过要注意,GENERATED ALWAYS 会限制手动指定 ID,后续需要显式覆盖时要使用 OVERRIDING SYSTEM VALUE。
我们先让 PostgreSQL 查看当前最大 ID:
SELECT MAX(id) FROM students;预期结果:
 max
-----
   1
然后执行下面的 SQL,让 Identity 序列从下一个编号开始:
SELECT setval(
    pg_get_serial_sequence('students', 'id'),
    (SELECT MAX(id) FROM students)
);
这里:
pg_get_serial_sequence():获取id对应的自动增长序列。MAX(id):查找当前最大的 ID。setval():调整序列当前值。
这样下一次自动生成的 ID 就应该是 2。
先到这了有点累了!